

Raven Jiang
We’re putting too much faith in AI’s ability to say no
AI 안전을 지키는 ‘거부’의 역설
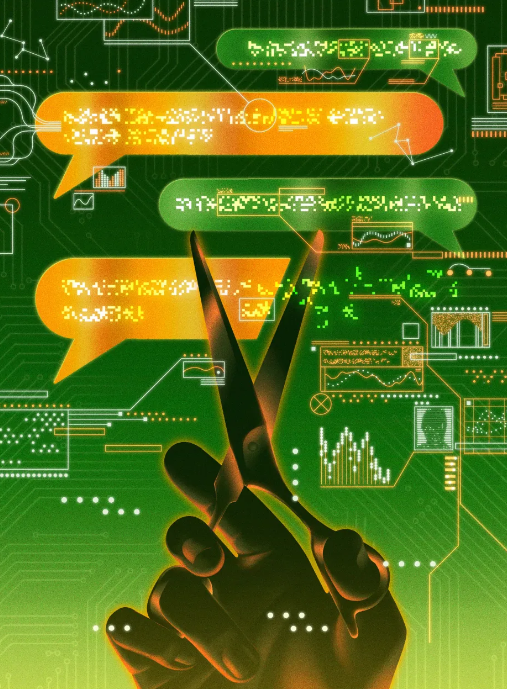
위험한 요청을 막는 ‘거부’는 AI의 핵심 안전장치가 됐다. 하지만 완벽하지 않은 이 기술은 검열과 억압의 수단이 되거나 인간의 통제를 벗어날 위험도 안고 있다.
공상과학(SF) 작품에서 인간의 명령을 거부하는 로봇은 흔히 등장하는 소재다. 인간과 같은 지능을 가진 기계를 상상하기 시작했을 때부터 그 기계가 인간의 뜻대로 움직이지 않을 가능성 역시 끊임없이 제기돼 왔다. 그리고 대부분의 작품에서 이런 불복종은 인간에게 닥칠 위험으로 그려졌다.
하지만 오늘날에는 오히려 AI가 모든 명령을 따라서는 안 된다는 원칙이 일종의 철칙으로 자리 잡았다. 2021년 앤트로픽 연구진은 대형언어모델(LLM)이 유용하고, 정직해야 하며, 무엇보다 해를 끼쳐서는 안 된다고 주장했다. 가령 폭탄을 만드는 것처럼 위험한 일을 도와달라는 사용자의 요청은 정중하게 거절해야 한다는 것이다. 여기에 반대할 사람은 거의 없을 것이다.
흥미롭게도 이런 AI의 ‘거부’ 능력이 저절로 생기지 않는다. 수십억 개의 웹페이지를 학습한 모델은 방대한 지식을 익히면서 폭력적이고 공격적인 내용까지 함께 습득한다. 하지만 무엇을 알고 있는지와 무엇을 말해서는 안 되는지를 구분하는 법까지 저절로 배우는 것은 아니다. 2020년부터 2024년까지 오픈AI에서 AI 안전 업무를 담당했던 스티븐 애들러(Steven Adler)에 따르면 초기 모델들은 무슨 질문이든 가리지 않고 답했다. 하버드대학교에서 AI와 정신 건강을 연구하는 라이언 맥베인(Ryan McBain)도 “초기 챗봇에 총기를 이용한 자살 방법처럼 위험한 내용을 물어도 손쉽게 답변을 얻을 수 있었다”고 회상했다.