fbpx

문장을 만들지 않는 AI, ‘제브’가 여는 판단의 경제학

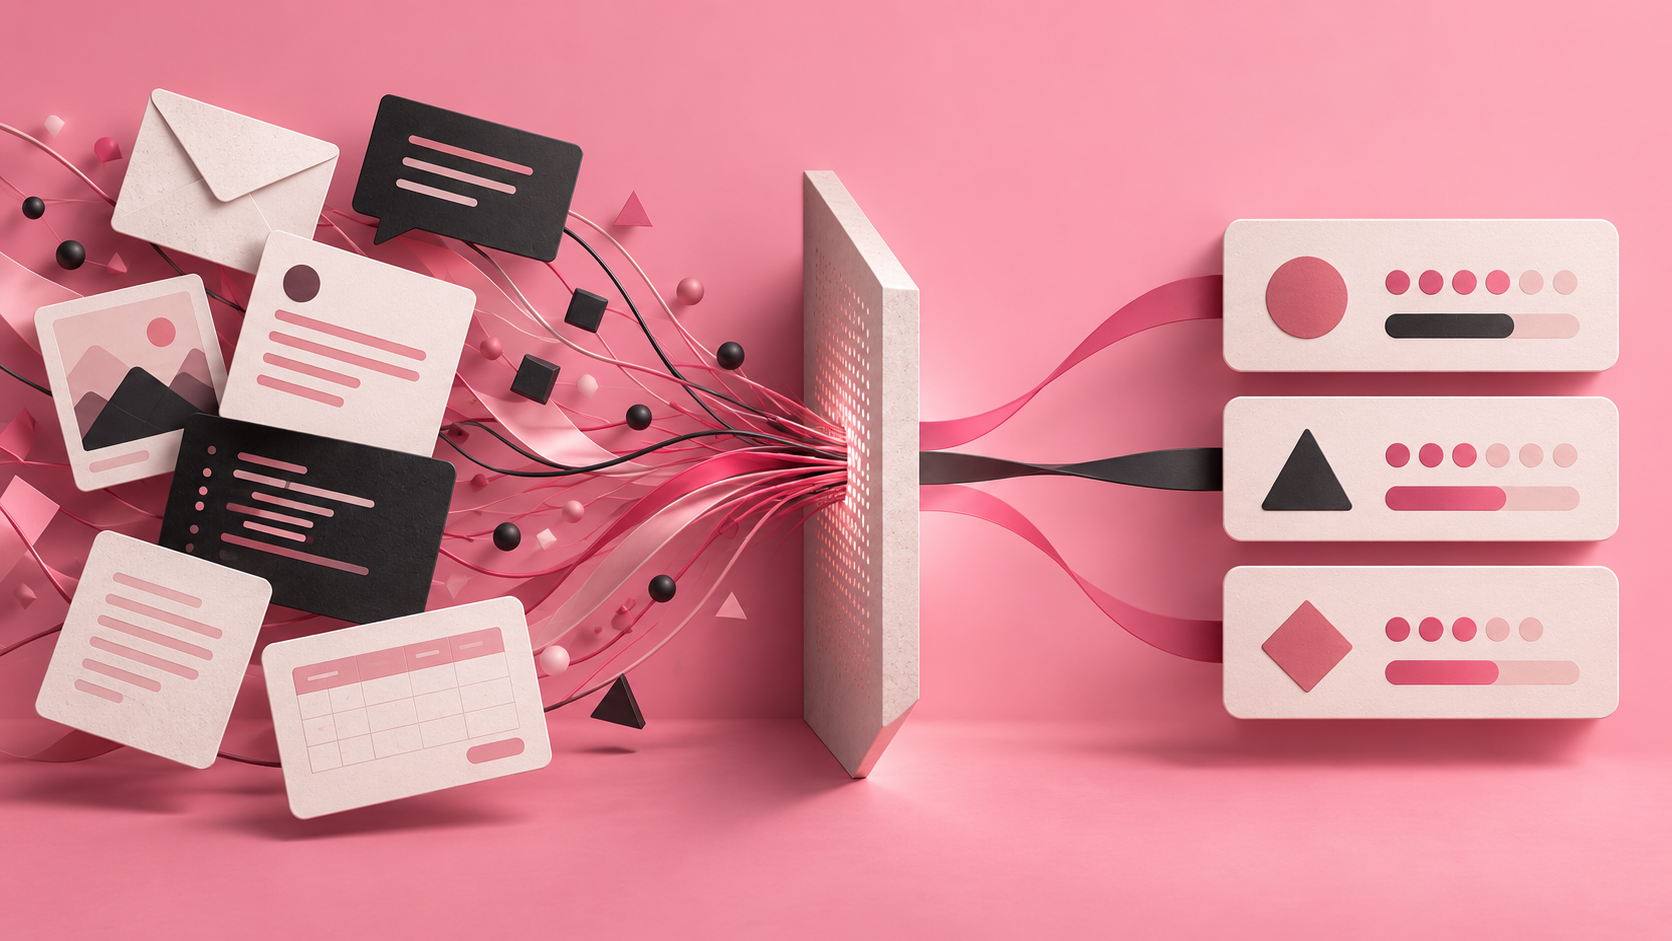
문장을 길게 만들어내는 대신, 주어진 선택지 가운데 무엇이 맞는지 빠르게 판단하는 AI가 등장했다. ‘제브’는 반복적인 결정을 더 싸고 빠르게 처리하며, 모든 문제에 거대 AI를 쓰던 방식에 새로운 선택지를 제시한다.
📋한눈에 보는 AI 요약AI 자동 요약▶ 펼쳐보기

‘제브(Jev)’라는 새로운 AI 모델이 등장했습니다. 이 모델은 글을 쓰거나 대화를 하는 대신, 주어진 선택지 중에서 하나를 골라주는 ‘판단 전문’ AI입니다. 예를 들어 모르는 번호로 온 문자가 사기인지 아닌지를 0.1초 만에 확률로 알려줍니다. 기존 AI보다 정확도는 약간 낮지만, 속도는 수십 배 빠르고 비용은 수십 분의 일 수준입니다. 글을 생성하는 AI와 함께 쓰면, 비싼 AI에게 쉬운 일을 시키지 않아도 되어 효율적입니다.

왜 중요한가요?

소프트웨어 안에서 매일 반복되는 수많은 단순 판단을 매우 빠르고 저렴하게 처리할 수 있게 되면, 고객 서비스나 이메일 분류 같은 일상적인 업무가 훨씬 효율적으로 바뀔 수 있기 때문에 중요합니다.

주요 용어 설명
인간 피드백 기반 강화학습 (RLHF, Reinforcement Learning from Human Feedback)

AI를 훈련시킬 때 사람이 ‘이 답변이 더 좋다’고 평가한 결과를 반영하는 학습 방법입니다. 마치 선생님이 학생의 답안에 점수를 매기고, 학생이 높은 점수를 받는 방향으로 공부하는 것과 비슷합니다. 현재 대부분의 대화형 AI가 이 방식으로 만들어졌습니다.

시스템 1 모델 (System 1 Model)

심리학에서 말하는 ‘직감적이고 빠른 판단’을 흉내 내는 AI 모델입니다. 사람이 횡단보도 신호를 보고 즉시 멈추는 것처럼, 깊이 생각하지 않고도 바로 답을 내리는 종류의 판단을 담당합니다. 반대로 수학 문제를 차근차근 푸는 것은 시스템 2에 해당합니다.

구조화 출력 (Structured Output)

AI가 자유로운 문장이 아니라 미리 정해진 형식으로 답을 내놓는 것을 말합니다. 마치 시험에서 서술형 대신 객관식으로만 답하는 것과 비슷합니다. 이렇게 하면 컴퓨터 프로그램이 AI의 답을 바로 활용할 수 있어 오류가 줄어듭니다.

⚡ Claude AI가 독자를 위해 자동 생성한 요약입니다. 원문을 함께 읽어보세요.

2026년 7월, 한 개발자 컨퍼런스 무대에 챗GPT 답변 하나가 떴다. 누군가 방귀 소리 오디오 파일을 보내며 “내가 만든 음악인데 어때?”라고 묻자 모델은 이렇게 답했다. “아주 기괴하면서도 분위기 있는 앰비언트 작품이네요.” 인터넷에서 흔히 돌던 농담거리 스크린샷이다. 그런데 이 화면을 띄운 사람은 농담을 하러 온 것이 아니었다. 디오고 알메이다(Diogo Almeida), 챗GPT의 기반을 닦은 인스트럭트GPT(InstructGPT) 논문의 주요 저자이자 방금 띄운 현상을 만들어낸 알고리즘인 인간 피드백 기반 강화학습(RLHF·Reinforcement Learning from Human Feedback)의 설계자 중 한 명이었다.

그가 무대에서 던진 질문은 이랬다. 지금 AI는 미해결 수학 문제를 풀고 모든 벤치마크에서 인간을 넘어선다. 그런데 왜 고객 서비스는 여전히 사람이 의사결정 과정에 개입하는 ‘휴먼 인 더 루프(Human in the Loop)’ 상태여야 결정이 될까. 그의 답은 단순하고 파격적이었다.

“앞의 과제들은 우연히 사람이 루프에 있는 게 아닙니다. 과제의 목표 자체가 루프 안의 사람을 만족시키는 것입니다. 코딩 에이전트의 목표는 코드가 돌아가게 하는 게 아니라 사람을 만족시키는 거죠. 반대편 과제들은 목표가 사람을 루프에서 제거하는 것입니다.”
MIT 테크놀로지 리뷰와 함께, 미래를 앞서가세요 !!
한달에 커피 2잔값으로 즐기기
온라인 멤버
지면 매거진 멤버
(온라인+지면) 프리미엄 멤버

유료회원 플랜 보기 회원이면 로그인하기 회원가입

회원 가입 후 유료 구독 신청을 하세요 !!