

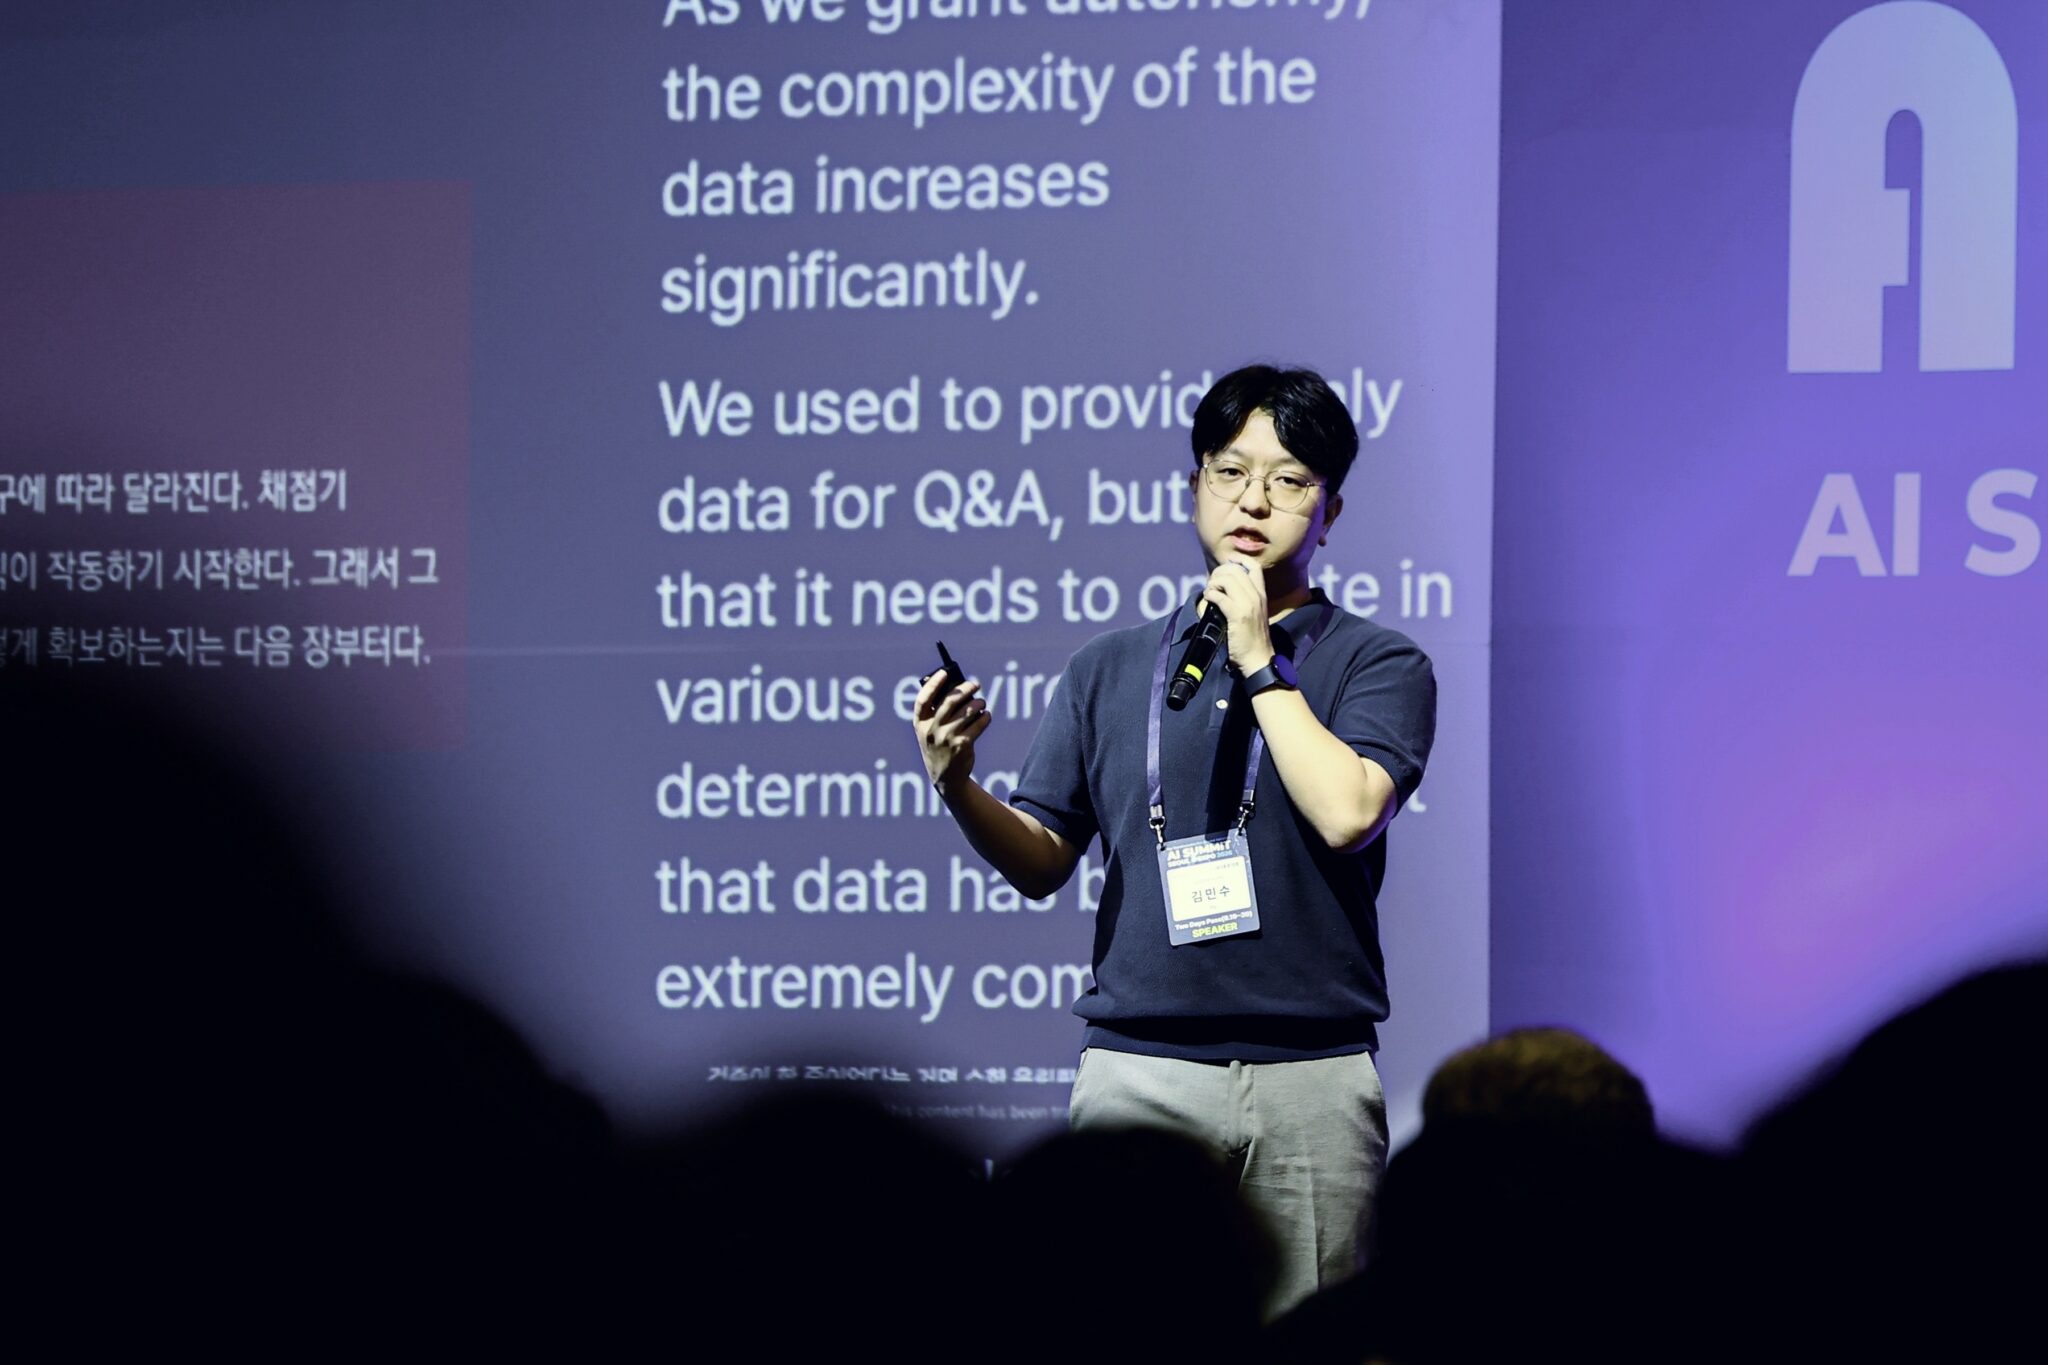
김민수 | 삼성전자 삼성리서치 AI센터 프로젝트 리더
AI 학습의 다음 단계, ‘스스로 만드는 데이터’
프런티어 AI 기업들이 전문가를 동원해 최신 AI 모델을 위한 새로운 데이터를 직접 만들고 있다. 삼성전자에서 AI 학습 데이터를 다뤄 온 김민수 PL은 이 변화가 데이터 선별을 넘어 생성·검증·재학습이 이뤄지는 ‘셀프 이볼빙 데이터’로 확장되고 있다고 설명한다.
AI는 이제 자신에게 필요한 학습 데이터를 스스로 만들어내기 시작했다. 한 문제를 맞히면 더 어려운 문제를 만들고, 틀리면 어디에서 문제 풀이가 막혔는지 찾아 그 약점을 겨냥한 문제를 다시 만든다. 그렇게 학습 결과에 따라 다음에 AI가 무엇을 배워야 할지 정하는 식으로 모델이 고도화한다.
현재 프런티어 AI 기업들이 맞닥뜨린 병목은 ‘다음에 어떤 문제를 풀게 할 것인가’이다.
지난 6월 미국 기술매체 와이어드는 페이스북 모회사 메타가 사내에서 직접 AI 학습용 퍼즐과 복잡한 코딩 문제를 직접 만들게 했다고 보도했다. 무려 약 6,500명의 엔지니어와 제품 담당자로 구성된 ‘응용 AI(Applied AI)’ 조직에 하달된 미션이었다. 일부 엔지니어들에게 공개된 코드와 문서를 더 읽히는 것만으로는 최신 모델의 약점을 드러낼 새로운 문제를 충분히 확보하기 어려워지자, 소프트웨어를 만들던 고급 인력을 AI 학습 데이터 제작에 투입한 것이다.
하지만 사람이 계속 새로운 문제를 만들어 주는 방식은 비용과 속도 면에서 한계가 뚜렷하다. 모델 성능이 높아질수록 더 어렵고 새로운 문제가 필요하고, 이를 설계하고 검증하는 데 드는 시간과 비용도 함께 늘어난다. 그래서 AI 경쟁에 뛰어든 기업들의 질문도 ‘데이터를 어디서 더 가져올 것인가’에서 ‘AI가 배워야 할 데이터를 스스로 만들어낼 수 있는가’로 옮겨가고 있다.